q-Voter em ordem superior
Para tentativas de generalizar/construir o modelo \(q\)-voter com interações de ordem superior, nos referimos à seção Generalizando o modelo para HONs, que discute o tema em detalhes, incluindo as dificuldades encontradas em modelos ingênuos.
Regras do q-Voter em ordem superior
Para construirmos o modelo \(q\)-voter em ordem superior, consideramos primeiramente:
- \(\mathcal{H} = (\mathcal{V},\mathcal{E})\), um hipergrafo onde \(\mathcal{V}\) é o conjunto de nós e \(\mathcal{E}\) o conjunto de hiperarestas;
- \(\mathcal{S}=\{1,\dots,S\}\), o conjunto de estados (opiniões) possíveis;
- \(\xi_t:\mathcal{V}\to\mathcal{S}\), a função que denota o estado de cada nó \(i\in\mathcal{V}\) no instante \(t\);
- \(\zeta_t^i:\mathcal{E}\to\{0\}\cup\mathcal{S}\), a função que denota o estado efetivo de cada hiperaresta \(e_j\in\mathcal{E}\) sob a perspectiva do nó \(i\) no instante \(t\), sendo que \(\zeta_t^i(e_j) = 0\) indica que a hiperaresta está “inativa” (despolarizada);
- \(\mathcal{V}_{t}^{i}(e_j,\sigma) = \{ k\in e_j : k\not=i \text{ e } \xi_t(k)=\sigma\}\), o conjunto de nós na hiperaresta \(e_j\) (excluindo o nó \(i\)) que se encontram no estado \(\sigma\).
A dinâmica do modelo é definida pelas seguintes regras:
- Em um dado instante \(t\), um nó \(i\in\mathcal{V}\) é escolhido aleatoriamente;
- \(q\) hiperarestas \(e_1,\dots,e_q\in\mathcal{E}\), tais que \(i\in e_j\), são sorteadas aleatoriamente com reposição;
- Para cada hiperaresta \(e_j\) selecionada, determinamos o conjunto \(\mathcal{V}_{t}^{i}(e_j,\sigma)\) de nós em \(e_j\) (excluindo \(i\)) que estão em um dado estado \(\sigma\in\mathcal{S}\):
- Se o número de nós que compartilham a opinião da maioria for maior ou igual a um limiar \(\theta_j = \theta_0 \cdot m_j\) (onde \(m_j\) é a ordem da hiperaresta \(e_j\)), isto é, se \(\max_{\sigma}\left|\mathcal{V}_t^i(e_j,\sigma)\right|\geq\theta_j\), então a hiperaresta é rotulada com o estado da maioria: \[\zeta_t^i(e_j) = \bar{\sigma} = \arg\max_{\sigma}\left|\mathcal{V}_{t}^{i}(e_j,\sigma)\right|;\]
- Caso contrário, ela é rotulada como despolarizada: \(\zeta_t^i(e_j)=0\), significando que não exerce influência na dinâmica;
- Se \(\zeta_t^i(e_j)=s\) para todas as \(q\) hiperarestas selecionadas (ou seja, se todas as \(q\) hiperarestas estão polarizadas e compartilham exatamente o mesmo estado majoritário \(s\)), então o nó \(i\) adota o estado \(s\): \(\xi_{t+\delta t}(i)=s\);
- Caso contrário, com probabilidade \(\varepsilon\), o nó \(i\) muda para um estado aleatório \(\xi_{t+\delta t}(i)=s^{\text{r}}\in\mathcal{S}\setminus\{\xi_t(i)\}\);
- O tempo é incrementado por \(\delta t = -\frac{\ln u^{\text{r}}}{N}\), com \(u^{\text{r}}\sim \mathcal{U}(0,1]\).
Para uma rede de interações aos pares (pairwise network) — isto é, uma rede em que todas as hiperarestas têm ordem \(m=1\) — este modelo se reduz perfeitamente ao modelo \(q\)-voter padrão. Neste caso, cada hiperaresta pode ser escrita como \(e_j = \{i,k\}\), resultando trivialmente em \(\zeta_t^i(e_j) = \xi_t(k)\).
Algoritmo de Gillespie
Podemos construir a taxa microscópica de um nó \(i\) flipar neste modelo considerando as probabilidades:
- \(\mathrm{P}( \xi(i) \to s)\): \(q\) hiperarestas consultadas estarem num estado \(s\) diferente de \(i\): neste caso, a opinião de \(i\) muda com taxa 1;
- \(\mathrm{P}( \xi(i) \to \xi(i) )\): \(q\) hiperarestas consultadas estarem no mesmo estado de \(i\): neste caso, a opinião de \(i\) muda com taxa 0 (não muda);
- Prob. complementar: não haver concordância entre as \(q\) hiperarestas consultadas: neste caso, a opinião de \(i\) muda com taxa \(\varepsilon\).
Vamos derivar para o caso mais simples \(\mathcal{S}=\{-1,1\}\). Deste modo, basta sabermos:
- \(x_i\): fração de hiperarestas que contém o nó \(i\) num estado diferente de \(i\);
- \(y_i\): fração de hiperarestas que contém o nó \(i\) no mesmo estado de \(i\);
- \(z_i\): fração de hiperarestas despolarizadas que contém o nó \(i\);
com \(x_i+y_i+z_i=1\). Como temos \(q\) consultas: \(\mathrm{P}( \xi(i) \to s)=x_i\cdot\cdots\cdot x_i = x_i^q\) e \(\mathrm{P}( \xi(i) \to \xi(i) ) = y_i\cdot\cdots\cdot y_i = y_i^q\). Logo: \[ \begin{align*} f( \cdot ; q,\varepsilon) =& \mathrm{P}( \xi(i) \to s) \times 1 + \mathrm{P}( \xi(i) \to \xi(i) ) \times 0 + \left(1-\mathrm{P}( \xi(i) \to s)-\mathrm{P}(\xi(i) \to \xi(i))\right)\times\varepsilon =\\ f(x_i,y_i;q,\varepsilon)= & x_i^q + \varepsilon\cdot\left(1-x_i^q-y_i^q\right)\,. \end{align*} \]
Veja que há uma sutileza na definição de \(x_i\) e \(y_i\): se há empate entre os dois estados, o algoritmo discreto escolhe um dos dois aleatoriamente, de modo que, aqui, é necessário que o caso do empate seja encarado como uma contribuição \(+0.5/k_i\) tanto para \(x_i\) quanto para \(y_i\).
Para estender a ideia para o caso com \(S\) estados, consideremos a seguinte notação:
- \(x_{i,\sigma}\): fração de hiperarestas que contém o nó \(i\) no estado \(\sigma\);
- \(x_{i,0}\): fração de hiperarestas despolarizadas que contém o nó \(i\);
com \(\sum_{\sigma\in\{0\}\cup\mathcal{S}} x_{i,\sigma}=1\). Desse modo, fixando \(\xi(t)=s_0\), a probabilidade de sortear uma dada aresta num estado \(\sigma\in\mathcal{S}\) é \(x_{i,\sigma}\); logo: \[ \begin{align*} &\mathrm{P}( \xi(i) \to s\not=s_0) = \sum_{\sigma\not=s_0} x_{i,\sigma}^q\,;\\ &\mathrm{P}( \xi(i) \to \xi(i) ) = x_{i,s_0}^q\,; \end{align*} \] e, assim: \[ f\big(\{x_{i,\sigma}\};q,\varepsilon\big)= \sum_{\sigma\not=s_0} x_{i,\sigma}^q + \varepsilon\cdot\left(1-\sum_{\sigma\in\mathcal{S}} x_{i,\sigma}^q\right)\,. \]
Esta é a taxa de mudança. Contudo, ela não determina qual estado o agente \(i\) irá escolher. Podemos construir a probabilidade dele selecionar um estado \(s\) qualquer, dado que ele vai flipar. Podemos usar a probabilidade condicional, lembrando que ele pode chegar ao estado \(s\) por dois eventos disjuntos: pelo consenso das \(q\) hiperarestas visitas, ou pelo sorteio uniforme do ruído. Assim:
\[\mathrm{P}(s_0\to s|\text{flip}) = \frac{\mathrm{P}(s_0\to s\cap\text{flip})}{\mathrm{P}(\text{flip})} = \frac{\mathrm{P}(s_0\to s)}{f\big(\{x_{i,\sigma}\};q,\varepsilon\big)} = \frac{1}{f\big(\{x_{i,\sigma}\};q,\varepsilon\big)}\left[x_{i,s}^q+\varepsilon\frac{1-\sum_{\sigma\in\mathcal{S}} x_{i,\sigma}^q}{(S-1)}\right]\,.\]
Veja que esta probabilidade esta devidamente normalizada: \[ \begin{align*} \sum_{\sigma\not=s_0} \mathrm{P}(s_0\to \sigma|\text{flip}) =& \frac{1}{f\big(\{x_{i,\sigma}\};q,\varepsilon\big)}\left[\sum_{\sigma\not=s_0}x_{i,\sigma}^q+\varepsilon\frac{1-\sum_{\sigma\in\mathcal{S}} x_{i,\sigma}^q}{(S-1)}\cdot(S-1)\right] =\\ =&\frac{1}{f\big(\{x_{i,\sigma}\};q,\varepsilon\big)}\left[ \sum_{\sigma\not=s_0} x_{i,\sigma}^q + \varepsilon\cdot\left(1-\sum_{\sigma\in\mathcal{S}} x_{i,\sigma}^q\right)\right]=\frac{f\big(\{x_{i,\sigma}\};q,\varepsilon\big)}{f\big(\{x_{i,\sigma}\};q,\varepsilon\big)}=1\,. \end{align*} \]
Assim, o algoritmo de Gillespie com amostragem de rejeição (eventos reais/nulos) pode ser escrito por:
- Em um dado instante \(t\), um nó \(i\in\mathcal{V}\) é escolhido aleatoriamente e a taxa \(f\big(\{x_{i,\sigma}\};q,\varepsilon\big)\) é determinada;
- O nó altera seu estado caso \(f\big(\{x_{i,\sigma}\};q,\varepsilon\big)\geq\max\{f\}r^{\text{r}}\) (com \(r^{\text{r}}\in[0,1)\)):
- O novo estado é determinado por \(s^\text{r}\sim \mathrm{P}(s_0\to s|\text{flip})\);
- O tempo é incrementado por \(\delta t = -\frac{\ln u^{\text{r}}}{N}\), com \(u^{\text{r}}\sim \mathcal{U}(0,1]\).
Benchmarks
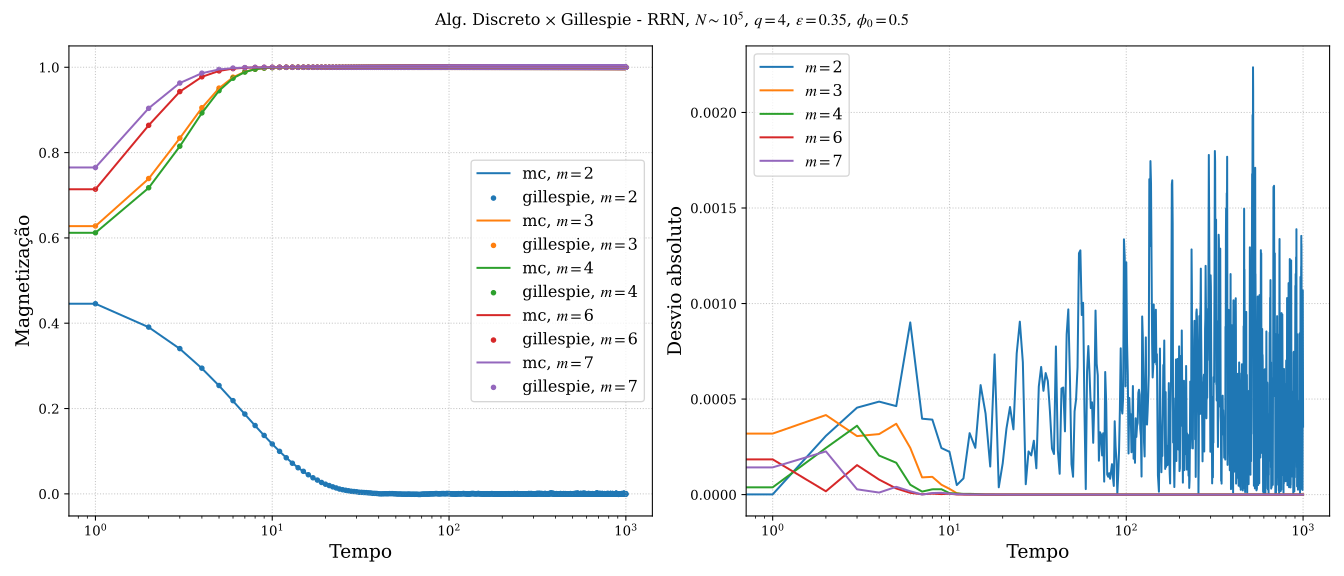
O gráfico abaixo mostra que os algoritmos levam aos mesmos resultados.
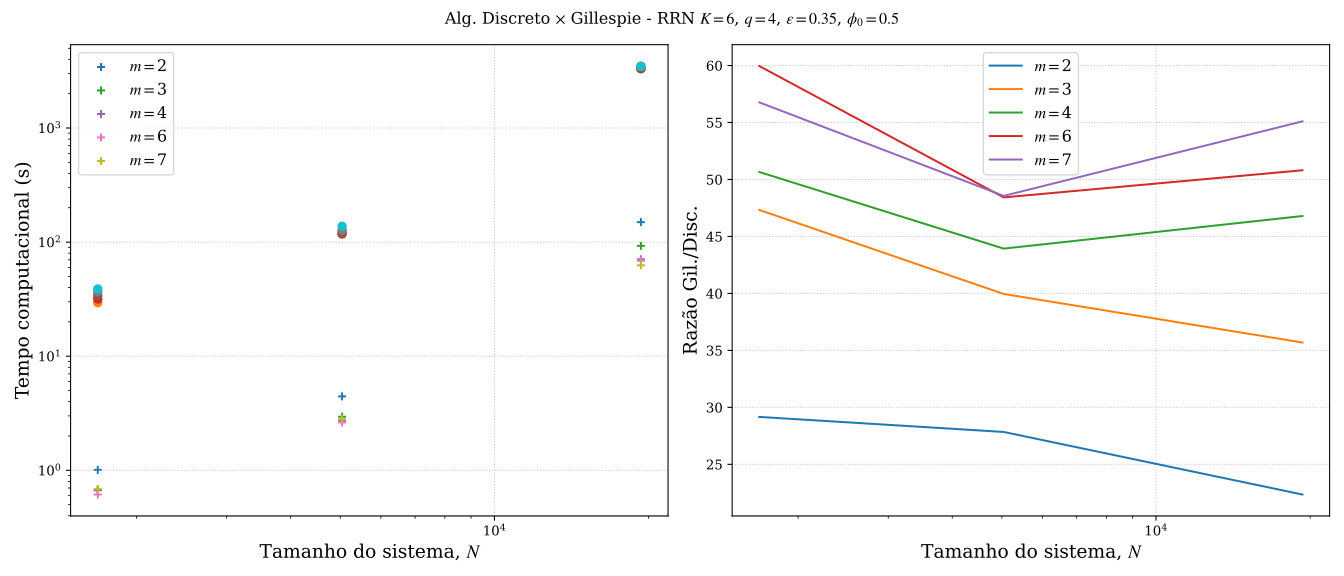
Gargalo no Gillespie
Otimização: lista dinâmica com deleção preguiça
Otimização: cachê de hiperarestas